Классификация текста количеством более двух меток одна из самых сложных задач в машинном обучение. Как, правило сырые данные перед обучением модели требуют серьёзной обработки.
Впервые с подобной задачей я столкнулся на своей работе – было необходимо обработать текст обратной связи посетителей портала с ограниченным количеством символов — около ста слов – сообщения могли состоять как из одного слова, так и из нескольких предложений. Количество классов – пять, от очень плохой «эмоциональной окраски» сообщения до очень хорошей.
- Данные
- Задача
- Генерация данных
- Баланс данных
- Краткое руководство по методам оценки моделей: машинное обучение
- Модели классификации машинного обучения
- Методы оценки моделей для классификационных моделей машинного обучения
- Матрица путаницы
- Кривая рабочих характеристик приемника (ROC)
- Пример: модели машинного обучения, которые Spotify использует, чтобы рекомендовать музыку, которая вам понравится.
- «Начиная»
- Мультиклассовая классификация с регрессией softmax и градиентным спуском
- Руководство по мультиклассовой классификации для новичков
- Логика регрессии Softmax
- Реализация Softmax
- Transformation to binary
- Расширение двоичного кода
- Машины опорных векторов
- Программирование мультивыражений
Данные
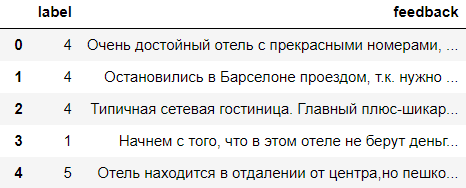
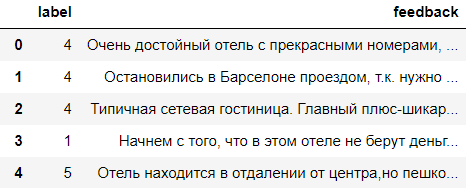
По причине NDA я не могу демонстрировать данные, которые предоставил клиент, поэтому специально для этой статьи я собрал собственный сет данных отзывов об отелях – стандартная история для классификации тональности.

На порядок меньше отзывов с метками
1 и 3
, и напротив крупный перевес представляет
5-ый класс
.
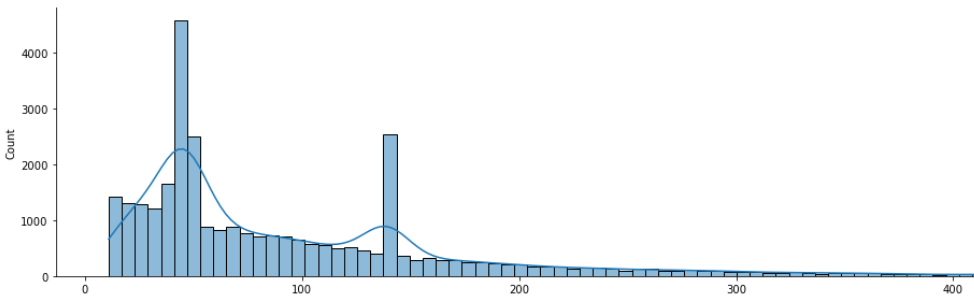
Так же тексты весомо отличаются по своей длине, при средней длине отзыва 50 токенов присутствуют крупное кол-во, превышающее значения 100 токенов – встречаются тексты и более тысячи.
Тестовые данные для чистоты эксперимента я выделил в отдельный фрейм размером 25000 строк – по 5000 сообщений на каждый класс. Моделируя реальную задачу, в тестовый набор я добавлял только сообщения с количеством токенов от 1 до 100.
Задача
В этом исследование я хочу разобрать отдельный сегмент предобработки данных, а именно показать, насколько балансировка тренировочных данных может качественно повлиять на конечный результат, а также чуть глубже погрузиться в суть работы механизма взвешивания слов TF-IDF
Генерация данных
Первым делом определимся с необходимым количеством отзывов для каждого класса. Я посчитал что 30-35 тысяч отзывов будет оптимальным решением. Необходимо сгенерить 20к текстов для первого и для третьего класса, а 15 тысячами текстов для 5-го придётся пожертвовать.
Существует множество способов генерации текста, в том числе с применением различных библиотек, я же реализую наиболее «дешевый» с точки зрения времени вычисления вариант, основанный на частоте использования биграмм
тренировочного корпуса. В данной задаче для нас не имеет значение семантический аспект генерируемых предложений
, так для взвешивания токенов будет использоваться метод TF-IDF. Далее в статье я подробней остановлюсь на этом методе, а здесь оставлю мой вариант скрипта, генерирующего текст для первого класса (очень плохие отзывы).
   import pandas as pd
import numpy as np
import sklearn
import re

import nltk
from nltk import tokenize
from nltk.tokenize import RegexpTokenizer

def get_text_for_label(df, label): # Получим список с текстами для каждого класса
    label = 'label == ' + str(label)
    df_label = df.query(label).drop(['label'], axis=1)
    return df_label.feedback.values.tolist()

feedback_label_1 = get_text_for_label(df_fin_feedback, 1) # К примеру, список для первого класса

def tokenize_sentences(text_corp): # Функцию разбиения текстов корпуса на токены с разбивкой по предложениям
    token_corp = []
    for text in text_corp:
        text = re.sub(r'\s+', ' ', text, flags=re.M)
        for sent in re.split(r'(?<=[.!?…])\s+', text):
            sent = sent.replace('\n',' ')
            for word in sent.split():
                token = re.search(r'[а-яёА-ЯЁa-zA-Z]+', word, re.I)
                if token is None:
                    continue
                token_corp.append(token.group().lower())
            token_corp.append('END_SENT_START') # В конце каждого предложения добавляем фиктивный токен
    return token_corp

token_label_1 = tokenize_sentences(feedback_label_1) # К примеру, список для первого класса
   from collections import Counter, defaultdict

def get_bigramms(token_list):
    bigramm_corp = []
    for i in range(len(token_list)-1):
        bigramm = token_list[i] + ' ' + token_list[i+1]
        bigramm_corp.append(bigramm) # Получим список биграмм

    unique_token_count = len(set(bigramm_corp)) # кол-во уникальных биграмм
    bigramm_proba = {} # Создаю словарик для результата: Ключ - биграмма. Значение - вероятность

    count_bigramm = Counter(bigramm_corp) # Создаю словарь для хранения частот биграмм
    count_token = Counter(token_list) # Создаю словарь для хранения частот токенов

    # Создаю словарь с группированными биграммами: ключи – отдельные токены,
    # в значение – список слов которые следуют за ними в корпусе
    # с собственной частотой (  { 'отель': [('отличным', 4.116e-06), ('вобщем', 2.058e-06), …)
    grouped_bigramms = defaultdict(list)
    for bigramm in set(bigramm_corp):
        first_word, second_word = bigramm.split()
        proba = (count_bigramm[bigramm] + 1) / (count_token[first_word] + unique_token_count) # Формула Лапласа
        grouped_bigramms[first_word].append((second_word, proba))
    return grouped_bigramms

grouped_bigramm_1 = get_bigramms(token_label_1) # На примере первого класса
Дальше код для самой генерации предложений. Скрипт выдаёт 4 предложения по 15 слов каждое, примерно следующего содержания 🙂
‘советовали как и вся мебель в качестве вступления хочу от отеля не звонила на пользу выбора. округа говорит по часа видимо поэтому администрация обратит внимание что пробовать желания нет чайника ни сосисок. отнесен к сведенью, линию стали ждать пока мы были с сухариками, отфутболивают, вечерний рынок где то. чернышевской, привлекательными чем я уезжала из санатория а тут просто праздник но очень экономит особенно если.’
   import random


def generate_texts(token_label, grouped_bigramm, label, count_text, count_sent, count_word):

    # Создаём словарь для подсчёта биграмм "исключений"
    exceptions_bigramm = defaultdict(int)
    # Создаём список уникальных токенов для старта предложения
    unique_token = list(set(token_label))

    texts = []
    for it_text in range(count_text):  # Цикл с диапазоном кол-ва текстов
        text = ''
        unique_word = set()

        # Цикл с диапазоном кол-ва предложений в тексте
        for it_sent in range(count_sent):
            len_sent = count_word
            # Генерим случайное слово для начала предложения для обеспечения стохастического процесса генерации предложения
            start_word = random.choice(unique_token)
            # Записываем в строку с финальным предложением первое стартовое слово
            final_sent = start_word
            # Множество уникальных слов, которые уже сгенерились в предложение (чтобы геенерация не зацикливалась)
            unique_word.add(start_word)

            for step in range(count_word):
                next_word = None  # Создаём переменную для нового слова
                frequency = 0  # Переменная-счётчик для частоты каждого нового слова

                # Проходим циклом по словарю с ключом биграммы и значением её частоты
                for second_word, freq in grouped_bigramm[start_word]:
                    bigramm = start_word + ' ' + second_word
                    # Устанавливаем значение максимального повторения слова в одном тексте
                    if exceptions_bigramm[bigramm] > 3:
                        continue
                    if freq > frequency and second_word not in unique_word and second_word != 'END_SENT_START':
                        next_word = second_word
                        frequency = freq  # Если второе слово проходит условие запоминаем его
                if next_word is None:  # Если подходящего по условиям слова не найдено, перезаписываем стартовое слово и начинаем поиск заново
                    start_word = random.choice(unique_token)
                    final_sent += ', ' + start_word
                    unique_word.add(start_word)
                else:
                    # Если после цикла нашли подходящее слова (которое запомнили в цикле) - записываем его в предложение
                    exceptions_bigramm[start_word + ' ' + next_word] += 1
                    start_word = next_word
                    final_sent += ' ' + next_word
                    unique_word.add(start_word)
            final_sent += '. '
            text += final_sent
        texts.append(text)

    generation_text_df = pd.DataFrame(texts, columns=['feedback'])  # Формируем фрейм из списка
    generation_text_df['label'] = label
    return generation_text_df[['label', 'feedback']]


label_1_df = generate_texts(token_label_1, grouped_bigramm_1, label=1, count_text=15000, count_sent=4, count_word=15)
Как, я упоминал ранее при данной задаче, для генерации семантика не имеет принципиального значения, важней частота появления слова в корпусе
и именно на такой результат заточен алгоритм. И теперь, запамятовав вышесказанное, перейдём к следующей части работы.
Баланс данных
Сгенерировав недостающее количество текстов, следует привести к балансу длину самих текстов. Для чего?
Что бы ответить на этот вопрос, вспомним как работает механизм взвешивания текста TF-IDF.
Мера TF-IDF является произведением двух сомножителей.

TF — частота слова — отношение числа вхождений некоторого слова к общему числу слов документа. Таким образом, оценивается важность слова в пределах отдельного документа.

IDF — обратная частота документа — инверсия частоты, с которой некоторое слово встречается в документах коллекции. Учёт IDF уменьшает вес широкоупотребительных слов. Для каждого уникального слова в пределах конкретной коллекции документов существует только одно значение IDF.
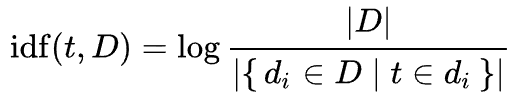
Большой вес в TF-IDF получат слова с высокой частотой в пределах конкретного документа
и с низкой частотой употреблений в других документах
. То есть, если мы имеем корпус с текстами с сильно различным количеством слов, мы рискуем получить завышенный показатель IDF если слово встречается только в маленьких текстах и наоборот если слово часто встречается много раз только в одном крупном тексте.
Ещё раз по-другому
Первый случай. Слово t встречается
пять раз в тексте длинной 500 слов
: знаменатель формулы IDF получит 1 бал и завысит показатель самого IDF, а следовательно, общий вес слова.Второй случай. Слово t встречается
по одному разу в пяти текстах длинной 100 слов
: знаменатель формулы IDF получит 5 балов и занизит показатель самого IDF, а следовательно, общий вес слова.
Подводя черту, выходит, что, зная длину текстов тестовых данных, мы можем качественно повлиять на результат взвешивания слов, корректируя длину текстов для тренировочных данных
. Если мы знаем, что в тестовой выборке сообщения длиной не более 100 слов, нам выгодней использовать веса, определённые во втором случае. Проверим гипотезу на практике
Приведём токены к их леммам
   from nltk.tokenize import RegexpTokenizer
from nltk import tokenize
import nltk
import pymorphy2
morph = pymorphy2.MorphAnalyzer()


def lemmatize(text):
    pattern = '[а-яёА-ЯЁ]+'
    tok = tokenize.RegexpTokenizer(pattern)
    text = tok.tokenize(text)

    def normalize(word):
        return morph.parse(word.lower())[0].normal_form

    return " ".join([normalize(it) for it in text if len(it) > 2])


df_feedback_train['feedback'] = df_feedback_train['feedback'].apply(lambda value: lemmatize(value))
Пропустим наш корпус через функцию разбиения/склеивания текстов и получим новый корпус с длинами документов, в заданном тестовым набором, диапазонах – от одного до ста токенов.
В функцию передаются аргументы: 1. сам корпус; 2. нижний порог слов в тексте; 3. верхний порог слов; 4. нижний порог слов в текстах «под отсечение».
   list_feedback_label_1 = get_text_for_label(df_feedback_train, 1) # Снова получим список документов из фрейма (пример для первого класса)

def balance_text(corp, low_thresh, high_thresh, low_remove_tresh):
    new_corp, temp = [], []
    for text in corp:
        if low_thresh <= len(text) <= high_thresh: # Если длина текста в пределах диапазона - оставляем текст без изменения
            new_corp.append(text)
        elif len(text) < low_thresh: # Если длина текста меньше нижнего порога - запоминаем, затем склеиваем с таким же текстом
            if len(temp) >= low_thresh:
                new_corp.append(temp)
                temp = text
            else:
                temp.extend(text)
        else:
            # Если длина текста больше верхнего порога - сплитим на меньшие тексты в рамках диапазона
            # Совсем мелкие хвостовые части не добавляем
            for j in range(0, len(text) - low_remove_tresh, high_thresh):
                new_corp.append(text[j:min(len(text), j + high_thresh)])

    if len(temp) > low_remove_tresh:
        new_corp.append(temp)

    return new_corp

label_1_feedback_balance = balance_text(list_feedback_label_1, 50, 100, 10) # Получаем сбалансированный текст для первого класса
# Всё тоже проделываем для всех 5-ти классов.
В результате получим следующее распределение количества токенов в документах.
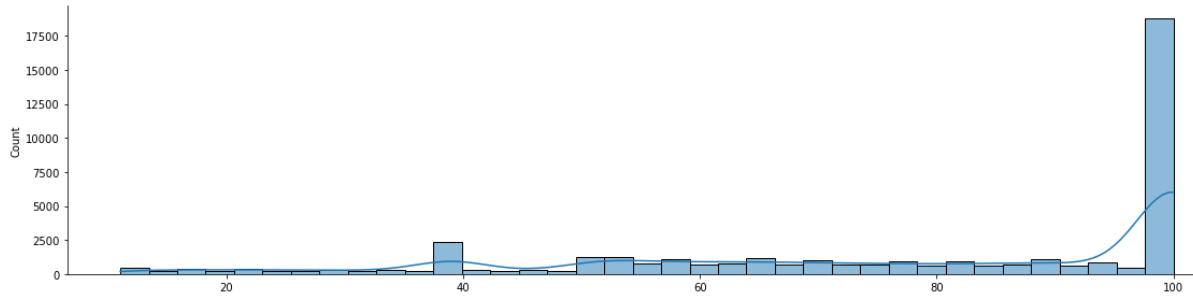
Здесь следует сделать отступление. Если взглянуть на аналогичный график распределения слов для первого класса тестовой выборе (график ниже), мы увидим картину идеального нормального распределения. Следовательно, и распределение для тренировочной выборки я стремился сделать схожим – нормальным, но именно нормальное распределение в тренировочной выборке дало худший показатель точности, а самый оптимальный представлен на графике выше.

Итак, мы получили корпуса со сбалансированным количеством слов, теперь отсечём лишнее – думаю 40к доков для каждого класса будет достаточно для демонстрации, затем обучим классификатор и сравним результат с результатами на разных этапах предобработки тренировочных данных. В связке с TF-IDF неплохо работает логистическая регрессия.
   from sklearn.feature_extraction.text import TfidfVectorizer
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import classification_report, confusion_matrix, accuracy_score

%matplotlib inline
import matplotlib.pyplot as plt
import seaborn as sns

# Отсекаем лишнее количество документов для выравнивания кол-ва текстов в представленных классов между собой
label_1_feedback_balance = label_1_feedback_balance[:40000] # Так для каждого класса

# Склеиваем один фрейм для тренировочных данных
def list_to_df(texts, label): # Функция для получения фрейма для каждого класса
    feedback = [' '.join(it) for it in texts]
    labels = [label for i in range(len(texts))]
    return pd.DataFrame(list(zip(labels, feedback)), columns =['label', 'feedback'])

df_label_1 = list_to_df(label_1_feedback_balance, 1) # Так для каждого класса (получаем фрейм)

df_feedback_train_balance = pd.concat([df_label_1, df_label_2, df_label_3, df_label_4, df_label_5], axis=0) # Склеиваем
df_feedback_train_balance = df_feedback_train_balance.sample(frac=1).reset_index(drop=True) # Не забыть перемешать тексты


X_train_text = df_feedback_train_balance['feedback'].values
X_test_text = df_feedback_test['feedback'].values
y_train = df_feedback_train_balance['label'].values
y_test = df_feedback_test['label'].values

v = TfidfVectorizer(norm=None, max_df=0.8, max_features=500, decode_error='replace') # Взвешиваем вектора
X_train_vector = v.fit_transform(X_train_text)
X_test_vector = v.transform(X_test_text)

clf = LogisticRegression( random_state=64, solver='lbfgs', max_iter=10000, n_jobs=-1) # Обучаем классификатор
clf.fit(X_train_vector, y_train)
y_pred = clf.predict(X_test_vector)

# Вывод результатов
print(accuracy_score(y_test, y_pred))
print(classification_report(y_test,y_pred))

T5_lables = ['5','4','3','2','1']

ax= plt.subplot()

cmm = confusion_matrix(y_test,y_pred)
sns.heatmap(cmm, annot=True, fmt='g', ax=ax);

ax.set_xlabel('Predicted labels');ax.set_ylabel('True labels');
ax.set_title('Confusion Matrix');
ax.xaxis.set_ticklabels(T5_lables); ax.yaxis.set_ticklabels(T5_lables);
Модель с загруженными начальными данными (не прошедшими предобработку) показала точность 0.51211
. Классы сильно разбалансированы, это хорошо просматривается в показателях precision и recall.

Модель с добавлением сгенерированных данных в слабо представленных классах дала результат точности предсказания в 0,56897
.
Модель же с добавлением сгенерированных данных и балансировкой текстов по длине показала точность 0,64984
. Уточнённые показатели так же выглядят приятней, да и прирост в точности в 8%
при многоклассовой классификации довольно ощутимый результат.

Спасибо за внимание!
Буду рад Вашим замечанием, с удовольствием отвечу на вопросы в комментариях.
Краткое руководство по методам оценки моделей: машинное обучение
Модели классификации машинного обучения
Методы оценки моделей для классификационных моделей машинного обучения
В машинном обучении мы часто используем модели классификации, чтобы получить прогнозируемый результат данных о населении. Классификация — это один из двух разделов контролируемого обучения, и он имеет дело с данными из разных категорий. Набор обучающих данных обучает модель предсказывать неизвестные метки данных о населении. Существует несколько алгоритмов: логистическая регрессия, K-ближайший сосед, дерево решений, наивный байесовский алгоритм и т. Д. Все эти алгоритмы имеют свой собственный стиль выполнения и различные методы прогнозирования. Чтобы найти наиболее подходящий алгоритм для конкретной бизнес-задачи, существует несколько методов оценки моделей. В этой статье будут обсуждаться различные методы оценки моделей.
Матрица путаницы
Вероятно, он получил свое название от состояния замешательства, с которым имеет дело. Если вы помните проверку гипотез, вы можете вспомнить две ошибки, которые мы определили как тип I и тип II. Как показано на рисунке 1, ошибка типа I возникает, когда отвергается нулевая гипотеза, чего не должно быть в действительности. Ошибка типа II возникает, когда альтернативная гипотеза верна, но вы не можете отклонить нулевую гипотезу.
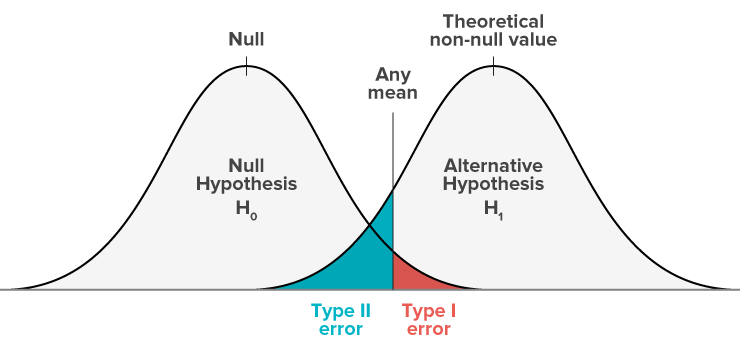
На рисунке 1 ясно показано, что выбор доверительного интервала влияет на вероятность возникновения этих ошибок. Но если вы попытаетесь уменьшить одну из этих ошибок, это приведет к увеличению другой.
Итак, что такое матрица неточностей?

Матрица путаницы — это изображение, приведенное выше. Это матричное представление результатов любого бинарного тестирования. Например, возьмем случай прогнозирования болезни. Вы прошли медицинское обследование, и с помощью его результатов вы сможете предсказать, есть ли у человека заболевание. Итак, на самом деле вы собираетесь проверить, приемлема ли гипотеза о признании человека больным или нет. Скажем, из 100 человек вы предсказываете, что 20 человек болеют болезнью. На самом деле заболеванием болеют всего 15 человек, и среди этих 15 человек вы поставили правильный диагноз 12. Итак, если я помещу результат в матрицу путаницы, он будет выглядеть следующим образом:

Итак, если мы сравним рис.3 с рис.2, мы найдем —
- Истинно-положительный: 12 (Вы правильно угадали положительный случай!)
- Истинно-отрицательный: 77 (вы правильно предсказали отрицательный случай!)
- Ложноположительный результат: 8 (Вы предсказали, что у этих людей есть болезнь, которой на самом деле нет. Но не волнуйтесь, это можно исправить в ходе дальнейшего медицинского анализа. Таким образом, это ошибка низкого риска. Это в данном случае ошибка типа II.)
- Ложноотрицательный: 3 (О, хо! Вы предсказали, что эти три бедняги подходят. Но на самом деле у них есть болезнь. Это опасно! Будьте осторожны! В данном случае это ошибка первого типа.)
Теперь, если я спрашиваю, какова точность модели прогнозирования, которой я следовал, чтобы получить эти результаты, ответ должен быть отношением точно прогнозируемого числа к общему числу людей
, равным ( 12 + 77) / 100 = 0,89
. Если вы внимательно изучите матрицу неточностей, вы обнаружите следующее:
- В верхнем ряду показано общее количество сделанных вами прогнозов как заболевание. Среди этих предсказаний вы правильно предсказали, что у 12 человек действительно есть болезнь. Итак, отношение 12 / (12 + 8) = 0,6
— это мера точности вашей модели в выявлении человека, у которого есть болезнь. Это называется точностью
модели . - Теперь возьмем первый столбец. В этом столбце представлено общее количество людей, которые на самом деле болеют этим заболеванием. И вы правильно предсказали 12 из них. Итак, отношение 12 / (12 + 3) = 0,8 — это мера точности вашей модели для выявления человека, имеющего болезнь, среди всех людей, у которых есть болезнь на самом деле. Это называется Отзыв
.
Теперь вы можете задать вопрос: зачем нам измерять точность или вспоминание, чтобы оценить модель?
Ответ: это настоятельно рекомендуется, когда конкретный результат очень чувствителен. Например, вы собираетесь построить модель банка для прогнозирования мошеннических транзакций. Мошеннические транзакции — не очень распространенное явление. Из 1000 транзакций может быть одна транзакция, которая является мошенничеством. Итак, несомненно, ваша модель очень точно предсказывает транзакцию как не мошенническую. Таким образом, в этом случае вся точность не имеет значения, так как она всегда будет очень высокой, независимо от точности прогноза мошеннических транзакций, так как это очень низкий процент среди всей совокупности. Но прогнозирование мошеннической транзакции как не-мошеннической нежелательно. Таким образом, в этом случае измерение точности будет играть жизненно важную роль для оценки модели. Это поможет понять из всех реальных мошеннических транзакций, сколько прогнозируется. Если он низкий, даже если общая точность высока, модель неприемлема.
Кривая рабочих характеристик приемника (ROC)
Измерение площади под кривой ROC также является очень полезным методом оценки модели. ROC — это соотношение истинно положительной скорости (TPR) и ложноположительной скорости (FPR) (см. Рис. 2). В нашем примере обнаружения болезни TPR — это мера отношения между количеством точных прогнозов людей, страдающих заболеванием, и общим количеством людей, болеющих этим заболеванием в действительности. FPR — это соотношение между количеством людей, у которых правильно прогнозируется отсутствие заболевания, и общим количеством людей, у которых болезнь не проявляется на самом деле. Итак, если мы построим кривую, она будет такой:
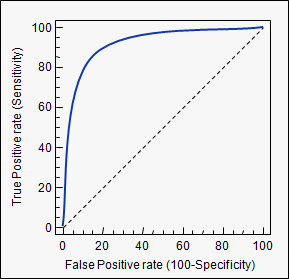
Синяя линия обозначает изменение TPR с другим FPR для модели. Более точное соотношение площади под кривой и общей площади (в данном случае 100 x 100) определяет точность модели. Если он становится равным 1, модель будет переобучена, а если оно будет меньше 0,5 (т. Е. Когда кривая проходит вдоль пунктирной диагональной линии), модель будет слишком неточной для использования.
Для моделей классификации существует множество других методов оценки, таких как диаграммы прироста и подъема, коэффициент Джини и т. Д. Но глубокие знания о матрице неточностей могут помочь очень эффективно оценить любую модель классификации. Итак, в этой статье я попытался развенчать заблуждения вокруг матрицы путаницы, чтобы помочь читателям.
Пример: модели машинного обучения, которые Spotify использует, чтобы рекомендовать музыку, которая вам понравится.
В начале 2000-х Songza внедрила ручную систему рекомендаций по музыке для своих слушателей, в которой команда музыкальных экспертов и кураторов создавала плейлисты. Но эти рекомендации не были объективными, так как зависели от личного вкуса кураторов.
Для слушателей это был средний опыт с изрядной долей попаданий и промахов, потому что невозможно было составить плейлист, который удовлетворял бы самые разные вкусы самых разных людей. В то время не существовало технологий и данных для создания списка воспроизведения, который можно было бы персонализировать по вкусу каждого отдельного слушателя.
Спустя несколько лет появился Spotify, предлагающий персонализированный еженедельный плейлист под названием Discover Weekly, который быстро стал одним из их флагманских предложений.
Каждый понедельник миллионы слушателей получают свежий плейлист с рекомендациями новых песен, адаптированных к их личным вкусам на основе истории прослушивания и песен, с которыми они взаимодействовали. Spotify использует комбинацию различных методов агрегирования и сортировки данных для создания своей уникальной и мощной модели рекомендаций, основанной на машинном обучении
.
« Одна из наших флагманских функций называется Discover Weekly. Каждый понедельник мы даем вам список из 50 треков, которые вы раньше не слышали и которые, как мы думаем, вам понравятся. Механизм машинного обучения, лежащий в основе его, и с тех пор он был усовершенствован, фактически присутствовал в Spotify немного раньше, чем появился Discover Weekly, просто поддерживая нашу страницу Discover
»- Дэвид Мургатройд, руководитель машинного обучения в Spotify.
Spotify использует три формы моделей рекомендаций для работы Discover Weekly.
1. Совместная фильтрация
Совместная фильтрация — это популярный метод, используемый системами рекомендателей для автоматического прогнозирования предпочтений пользователей на основе предпочтений других подобных пользователей.
В Spotify алгоритм совместной фильтрации сравнивает несколько созданных пользователями плейлистов, в которых есть песни, которые пользователи слушали. Затем алгоритм просматривает эти списки воспроизведения, чтобы найти другие песни, которые появляются в списках воспроизведения, и рекомендует эти песни.
Этот фреймворк выполняется с помощью матричной математики в библиотеках Python. Сначала алгоритм создает матрицу всех активных пользователей и песен. Затем библиотека Python запускает серию сложных формул факторизации для матрицы. Конечным результатом являются два отдельных вектора, где X — пользовательский вектор, представляющий вкус отдельного пользователя. Вектор Y представляет собой профиль отдельной песни. Чтобы найти пользователей со схожим вкусом, совместная фильтрация будет сравнивать данный пользовательский вектор с каждым без исключения пользовательским вектором, чтобы получить аналогичный пользовательский вектор в качестве выходного. Та же процедура применяется к векторам песни.
Spotify полагается не только на совместную фильтрацию. Вторая используемая модель рекомендаций — это НЛП.
2. Обработка естественного языка
НЛП — это способность алгоритма понимать речь и текст в режиме реального времени. NLP Spotify постоянно просматривает Интернет в поисках статей, сообщений в блогах или любого другого текста о музыке, чтобы придумать профиль для каждой песни.
Со всеми этими очищенными данными алгоритм НЛП может классифицировать песни на основе языка, на котором они описаны, и может сопоставлять их с другими песнями, обсуждаемыми в том же ключе. Артистам и песням назначается классификация ключевых слов на основе данных, и каждому термину присваивается определенный вес. Подобно совместной фильтрации, создается векторное представление песни, которое используется для предложения похожих песен.
3. Сверточные нейронные сети
Сверточные нейронные сети используются для оттачивания системы рекомендаций и повышения точности, поскольку менее популярные песни могут игнорироваться другими моделями. Модель CNN обеспечивает рассмотрение малоизвестных и новых песен.
Модель CNN наиболее часто используется для распознавания лиц, и Spotify настроил ту же модель для аудиофайлов. Каждая песня преобразуется в необработанный аудиофайл в виде волны. Эти формы волны обрабатываются CNN, и им назначаются ключевые параметры, такие как удары в минуту, громкость, мажорная / минорная тональность и так далее. Затем Spotify пытается сопоставить похожие песни, которые имеют те же параметры, что и песни, которые их слушатели любят слушать.
С помощью этих ключевых моделей машинного обучения
Spotify может составить уникальный плейлист с музыкой, которая каждую неделю удивляет своих слушателей песнями, которые они никогда бы не нашли в ином случае.
Ключевой проблемой многих моделей машинного обучения является отсутствие доступа к чистым, структурированным данным, которые можно обрабатывать. Spotify удалось обойти эту проблему благодаря доступу к огромным объемам данных, которые они собирают от своих пользователей. Они смогли показать отличный пример эффективного использования моделей машинного обучения, чтобы предоставить своим пользователям непревзойденный персонализированный опыт.
Сайкат Бхаттачарья (Saikat Bhattacharya) — старший инженер-программист в Freshworks, он участвует в программе Машинное обучение PGP
от Great Learning
. Эта статья изначально была опубликована на
Towards Data Science и была распространена с разрешения автора.
«Начиная»
Мультиклассовая классификация с регрессией softmax и градиентным спуском
Руководство по мультиклассовой классификации для новичков

В своей предыдущей статье я говорил о бинарной классификации с логистической регрессией.
У нас был список результатов экзаменов и средних баллов учащихся, а также сведения о том, были ли они зачислены в городскую магнитную школу.
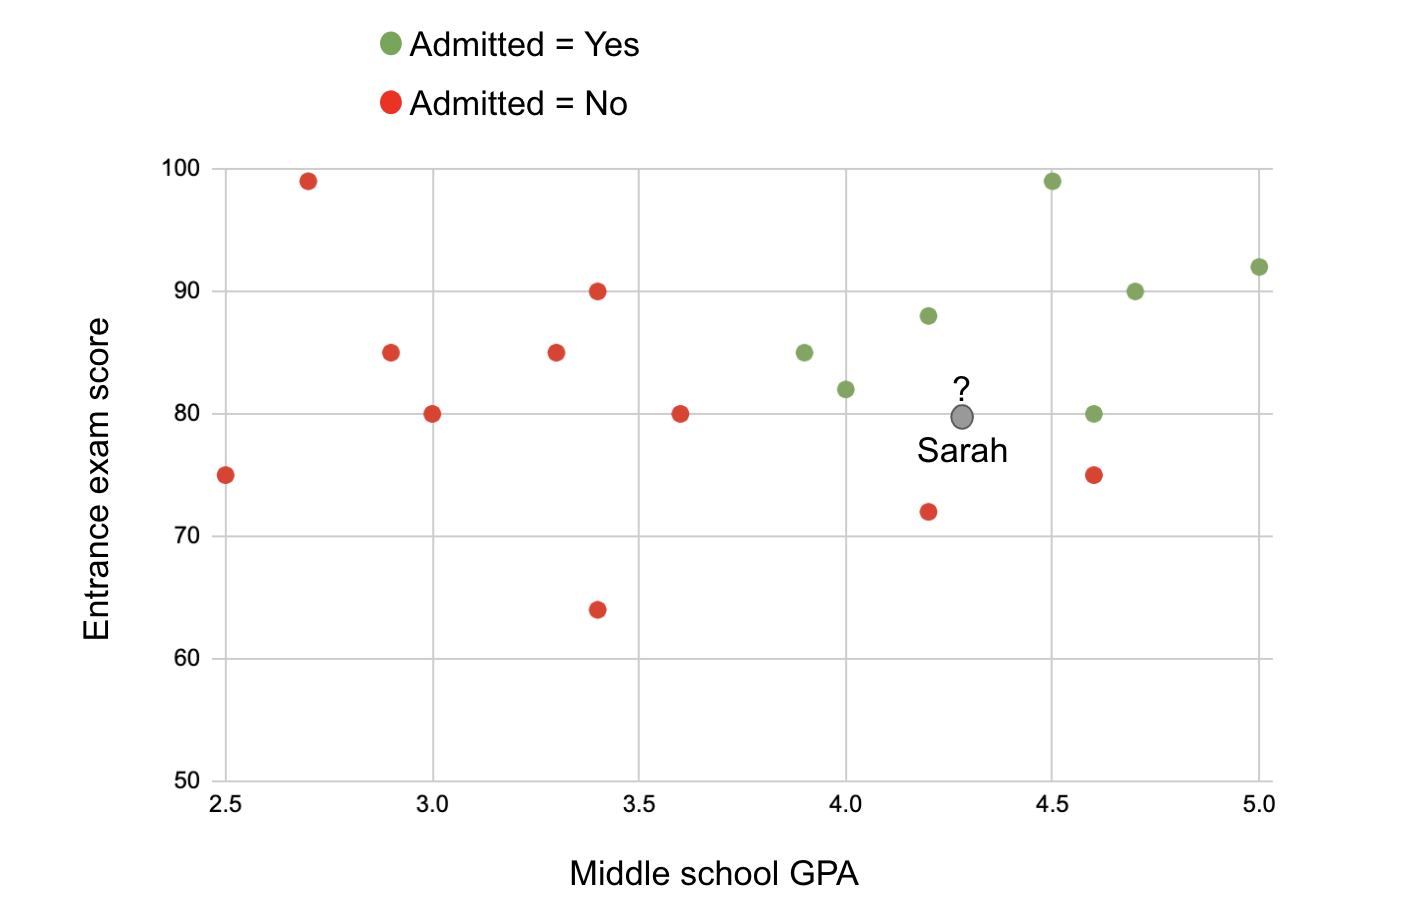
На основе этих данных мы хотели предсказать, поступят ли Сары. Мы использовали логистическую регрессию, чтобы найти вероятность того, что Сара будет допущена, которая оказалась 0,665. Таким образом, мы классифицировали ее как «допущенную».
А что, если мы введем третью категорию: лист ожидания
.
Вот наш новый набор данных:
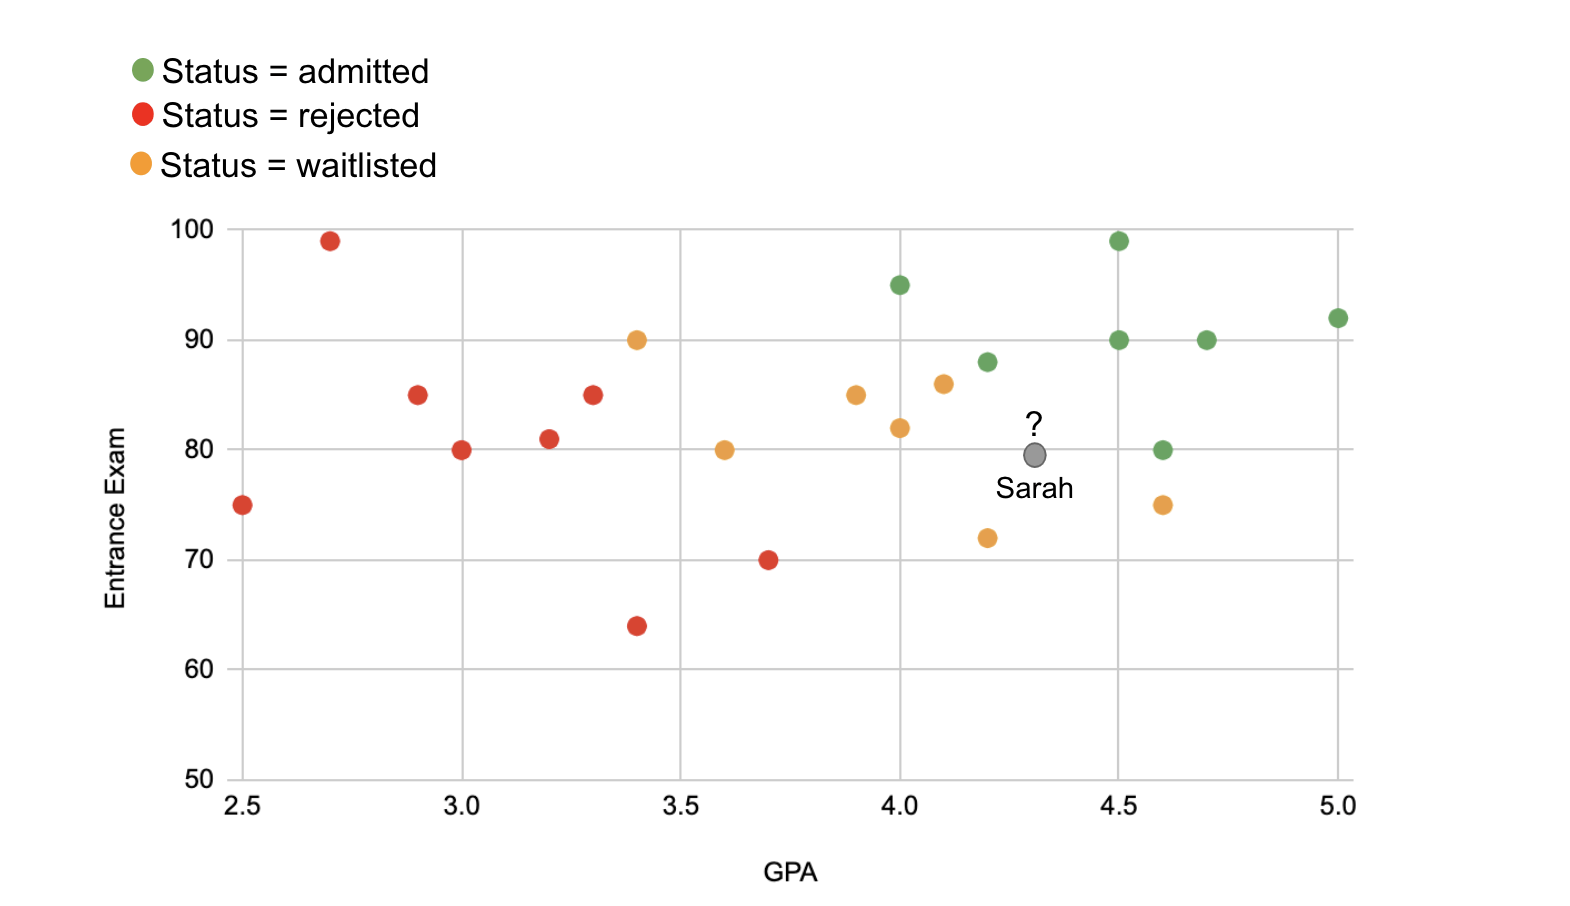
Учитывая средний балл Сары 4,3 и балл на экзамене 79, можем ли мы предсказать, будет ли она зачислена, отклонена или внесена в список ожидания?
Это мультиклассовая классификация, потому что мы пытаемся отнести точку данных к одной из трех категорий (а не к одной из двух).
Одним из алгоритмов решения мультиклассовой классификации является регрессия softmax.
Эта статья предполагает знакомство с логистической регрессией и градиентным спуском. Нужна переподготовка? Прочтите сначала это
.
Логика регрессии Softmax
В конечном итоге алгоритм найдет границу для каждого класса. Что-то вроде изображения ниже (но не на самом деле изображение ниже):
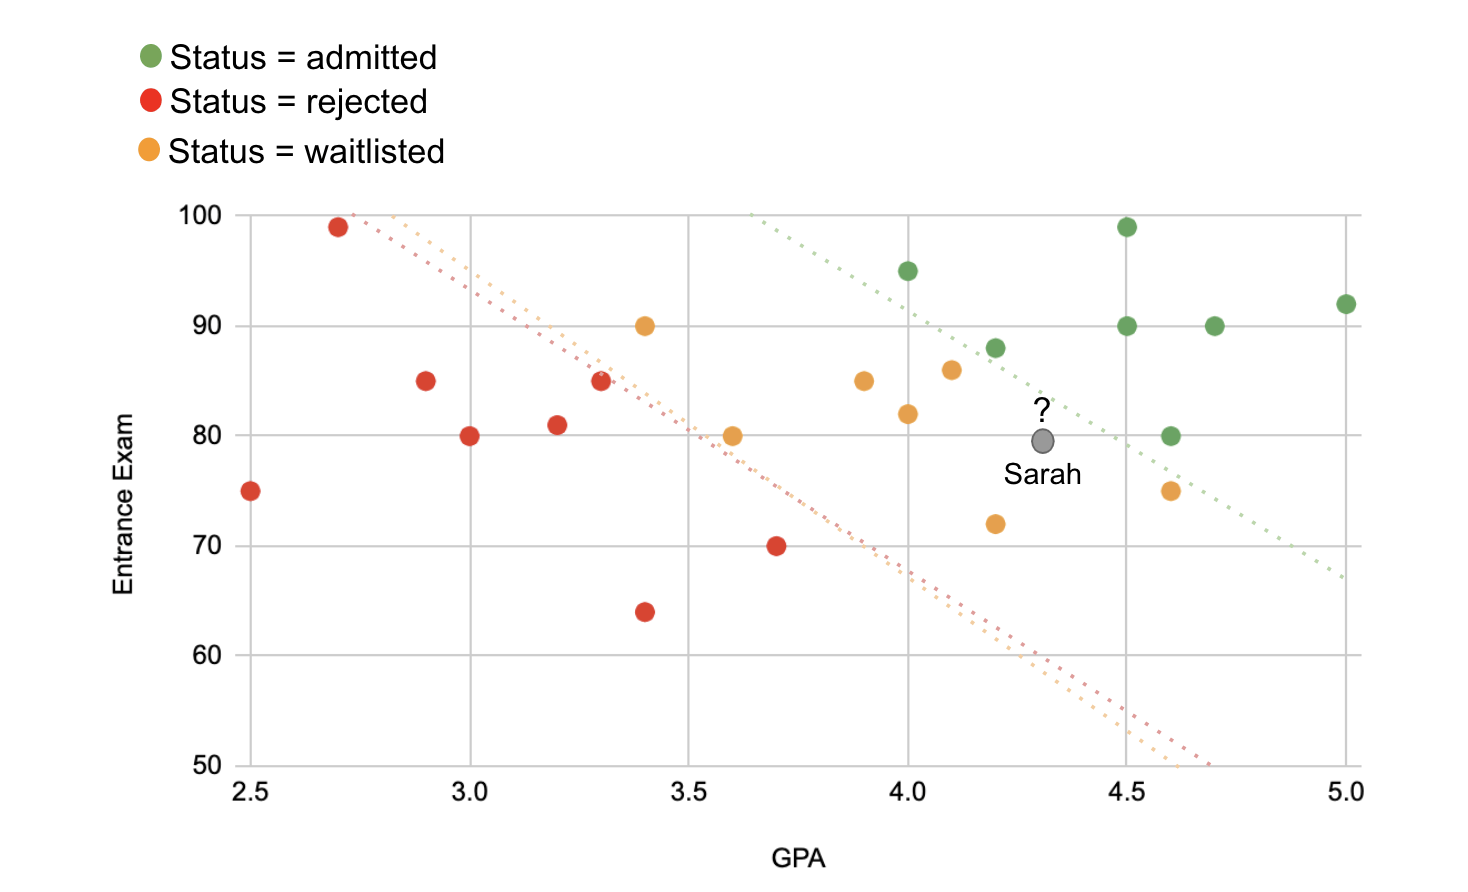
Примечание: мы, люди, можем легко взглянуть на диаграмму и отнести Сару к списку ожидания, но позвольте машине выяснить это с помощью машинного обучения, да?
Как и в случае линейной и логистической регрессии, мы хотим, чтобы выходные данные модели были как можно ближе к фактической метке. Любое различие между меткой и выводом приведет к «потере» функции. Модель учится, минимизируя эту потерю.
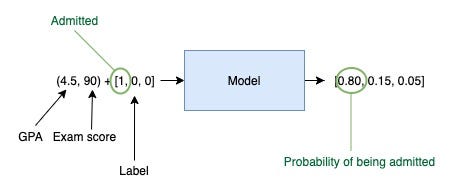
В этом примере есть 3 класса, поэтому метка наших данных вместе с выходными данными будет векторами из 3 значений. Каждое значение связано со статусом допуска.
Если этикетка такая, что:
  admitted = [1, 0, 0]
waitlisted = [0, 1, 0]
rejected = [0, 0, 1]
тогда выходной вектор будет означать:
   [probability of being admitted,
probability of being waitlisted,
probability of being rejected]
Таким образом, в регрессии softmax мы хотим найти распределение вероятностей по всем классам для каждой точки данных.
Мы используем функцию softmax, чтобы найти это распределение вероятностей:
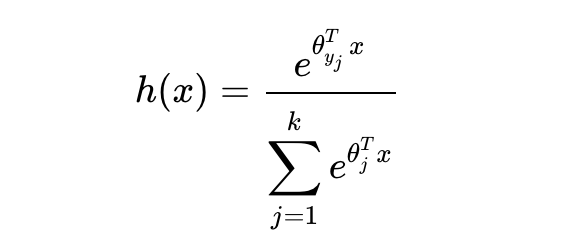
Почему функция softmax? Я думаю, что эти функции лучше всего пояснить на примере. Давайте посмотрим на пример:
Средний балл = 4,5, балл на экзамене = 90 и статус = допущен.
Когда мы обучаем модель, мы инициализируем модель с предполагаемым набором параметров — theta. Мы оптимизируем эти параметры с помощью градиентного спуска. Поскольку у нас есть 3 класса (принятый, отклоненный и внесенный в список ожидания), нам потребуется три набора параметров. У каждого класса будет свой набор параметров.
Пусть тета будет иметь форму:
Давайте инициализируем тэты:
  theta_admitted = [  -250, 40, 1]
theta_waitlisted = [-220, 40, 1]
theta_rejected = [-220, 40, 1]
Почему эти ценности?
Помните, что линия y = mx + b? Строка, заданная начальными тетами, будет следующей:
  admitted:
-250 + 40x + y = 0
y = -40x + 250
waitlisted:
-220 + 40x + y = 0
y = -40x + 220
rejected:
-220 + 40x + y = 0
y = -40x + 220
Если я просто посмотрю на данные, я могу увидеть, что линия, отделяющая «допущенные» от остальных, имеет точку пересечения по оси Y около 250 и наклон около -40.
Примечание. Это только начало, но на самом деле эти параметры никогда не сработают. Во-первых, параметры для списка ожидания и отклонения одинаковы, поэтому параметры всегда будут возвращать одинаковую вероятность для списка ожидания и отклонения, независимо от того, что вводится. Во-вторых, отличается только предвзятость, а отклоненные и внесенные в список ожидания имеют большую предвзятость, чем допущенные (-220–250). Следовательно, независимо от того, что это за вход, эти параметры вернут 0 для допущенных и 0,5 для двух других.
Но с плохими параметрами можно начинать, градиентный спуск исправит!
Давайте визуализируем, что делает функция softmax.
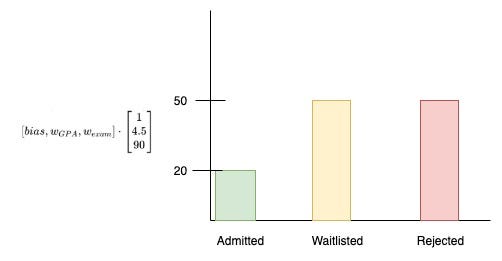
Что происходит, когда мы пропускаем точку данных через уравнение softmax? Опять же, наша точка данных: средний балл = 4,5, балл за экзамен = 90.
Сначала мы находим скалярное произведение параметров и точки данных:
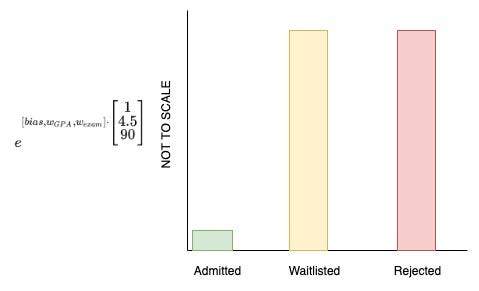
Затем мы возводим это значение в степень, чтобы избавиться от любых потенциальных отрицательных скалярных произведений:
Наконец, мы нормализуем его, чтобы получить распределение вероятностей:

Поскольку наш первоначальный набор параметров не подходит, модель выводит 0,5 для отклоненных и 0,5 для внесенных в список ожидания, даже если метка допущена.
Алгоритм машинного обучения скорректирует смещение, вес GPA и вес экзаменационной оценки, чтобы вектор входных данных создавал выходное распределение, которое точно соответствует метке входа.
На самом деле нам нужно, чтобы наша модель выводила что-то вроде:
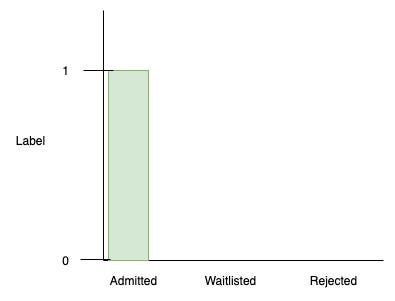
Итак, давайте изменим параметры для всех трех классов, чтобы повысить точность.
Один из способов сделать это — градиентный спуск.
Градиентный спуск работает за счет минимизации функции потерь. В линейной регрессии эта потеря представляет собой сумму квадратов ошибок. В регрессии softmax эта потеря представляет собой сумму расстояний между метками и выходными распределениями вероятностей.
Эта потеря называется кросс-энтропией. Формула перекрестной энтропии одной точки данных:
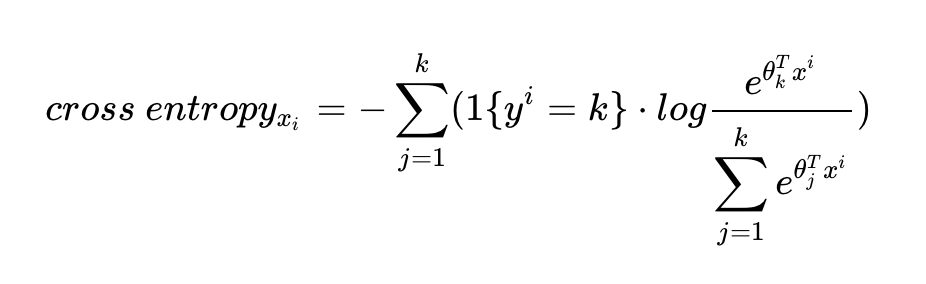
По сути, эта функция измеряет, насколько похожи векторы метки и вывода. Вот хорошая запись в блоге
, в которой подробно рассказывается об этом уравнении.
Полная перекрестная энтропия или потери будут суммой всех перекрестных энтропий.
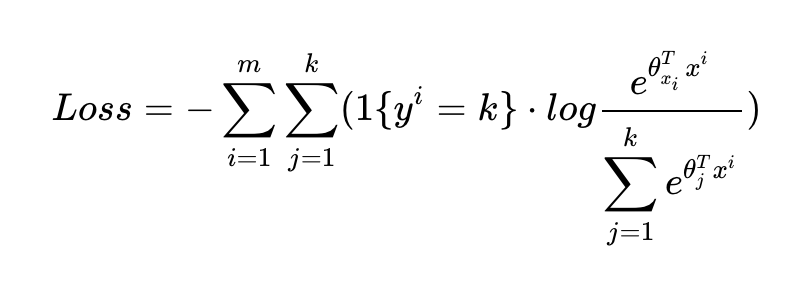
Мы берем производную по тета от этой потери, чтобы выполнить градиентный спуск.
Новые параметры для класса k
после каждой итерации:
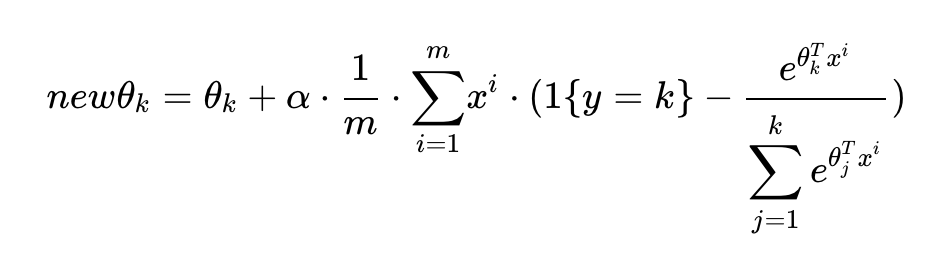
Мы используем эту формулу для вычисления новых тета для каждого класса.
Теперь давайте реализуем алгоритм, чтобы прийти к оптимальным параметрам theta.
Реализация Softmax
Я реализовал регрессию softmax для своего примера здесь
:
Вот как вы тестируете в терминале:
  >>> dataset = [.] # copy it from the gist
>>> from softmax_regression import SoftmaxRegression
>>> s = SoftmaxRegression(dataset)
>>> s.iterate()
Каждая итерация вычисляет общую перекрестную энтропию и получает новые параметры для каждого класса.
После многих и МНОГИХ итераций и настройки начальных параметров я смог прийти к параметрам:
  theta_admitted = [-392.56407961, 56.75483745, 2.01880429]
theta_waitlisted = [-200.59246564, 33.92260307, 0.89946962]
theta_rejected = [-157.84345476, 26.32255948, 0.70172608]
Давайте проверим эти параметры с помощью вышеупомянутой точки данных: средний балл = 4,5, оценка за экзамен = 90 и статус = допущен. Модель должна вывести значение, близкое к 1 для допущенных и 0 для двух других статусов.
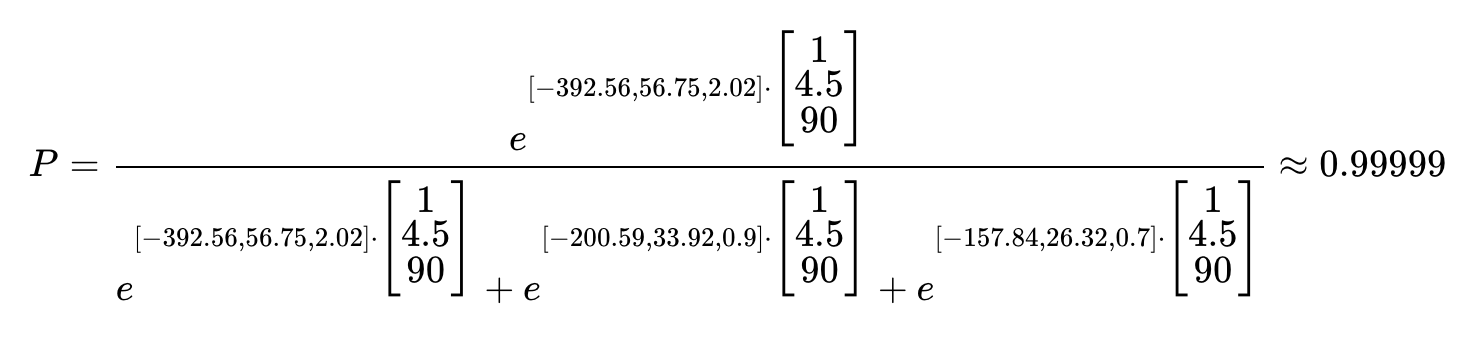
Ах! Намного лучше.
Теперь предскажи, допустят ли Сару!
Вот распределение вероятностей для среднего балла = 4,3 и балла за экзамен = 79:

Сара в списке ожидания. Грустный. Но мы уже знали, что это так.
Вот график с граничными линиями, определенными параметрами.

Честно говоря, это застало меня врасплох. Я пытался найти хорошее объяснение того, как интерпретировать параметры геометрически, но пока без особого успеха.
Если у вас есть хорошее объяснение, почему регрессия softmax не дает четких границ, прокомментируйте ниже.
Регрессия Softmax, наряду с логистической регрессией, не единственный способ решения проблем классификации. Эти модели хороши, когда данные более или менее линейно разделимы. Однако, когда данные нельзя разделить линейно, мы обращаемся к другим методам, таким как опорные векторные машины, деревья решений и k-ближайшие соседи.
В следующей статье я сравню разные алгоритмы обучения для решения задач классификации и расскажу о плюсах и минусах каждого из них. Будьте на связи!
From Wikipedia, the free encyclopedia
In machine learning
and statistical classification
, multiclass classification
or multinomial classification
is the problem of classifying instances into one of three or more classes (classifying instances into one of two classes is called binary classification
).
While many classification algorithms (notably multinomial logistic regression
) naturally permit the use of more than two classes, some are by nature binary
algorithms; these can, however, be turned into multinomial classifiers by a variety of strategies.
Multiclass classification should not be confused with multi-label classification
, where multiple labels are to be predicted for each instance.
The existing multi-class classification techniques can be categorised into
- transformation to binary
- extension from binary
- hierarchical classification. [1]
Transformation to binary
This section discusses strategies for reducing the problem of multiclass classification to multiple binary classification problems. It can be categorized into one vs rest
and one vs one
. Методы, разработанные на основе сведения многоклассовой задачи к множеству бинарных задач, также можно назвать методами преобразования проблем.
- Вводы:
- , обучающийся (алгоритм обучения бинарных классификаторов)
- образцы
- метки, где ∈ {1, … } — метка образца
- Выход:
- список классификаторов для ∈ {1, …, }
- Процедура:
- Для каждого в {1, …, }
- Создайте новый вектор меток, где = if y
я
= к
и z
я
= 0
иначе - Подайте заявку на , чтобы получить
- Создайте новый вектор меток, где = if y
- Для каждого в {1, …, }
Принятие решений означает применение всех классификаторов к невидимому образцу и предсказание метки, для которой соответствующий классификатор сообщает наивысший показатель достоверности:

Расширение двоичного кода
В этом разделе обсуждаются стратегии расширения существующих бинарных классификаторов для решения задач многоклассовой классификации. На основе нейронных сетей разработано несколько алгоритмов.
, деревья решений
, k-ближайшие соседи
, наивный Байес
, машины опорных векторов
и машины экстремального обучения
для решения проблем многоклассовой классификации. Эти типы методов также можно назвать методами адаптации алгоритмов.
Мультиклассовые перцептроны обеспечивают естественное расширение проблемы мультиклассов. Вместо одного нейрона в выходном слое с двоичным выходом можно использовать N двоичных нейронов, что приведет к многоклассовой классификации. На практике последний слой нейронной сети обычно представляет собой функцию softmax .
слой, который представляет собой алгебраическое упрощение N логистических классификаторов, нормализованных для каждого класса суммой N-1 других логистических классификаторов.
Машины экстремального обучения
Машины экстремального обучения
(ELM) представляет собой особый случай однослойных нейронных сетей прямого распространения (SLFN), в которых входные веса и смещения скрытых узлов могут выбираться случайным образом. В ELM внесено множество вариантов и разработок для многоклассовой классификации.
k-ближайшие соседи
kNN считается одним из старейших алгоритмов непараметрической классификации. Чтобы классифицировать неизвестный пример, измеряется расстояние от этого примера до любого другого обучающего примера. Определяются k наименьших расстояний, и класс, наиболее представленный этими k ближайшими соседями, считается меткой выходного класса.
Наивный Байес
является успешным классификатором, основанным на принципе максимума апостериори (MAP). Этот подход естественным образом расширяется на случай наличия более двух классов и, как было показано, работает хорошо, несмотря на лежащее в его основе упрощающее предположение об условной независимости .
.
Обучение дереву решений
является мощным методом классификации. Дерево пытается вывести разделение обучающих данных на основе значений доступных функций, чтобы получить хорошее обобщение. Алгоритм может естественным образом решать задачи бинарной или многоклассовой классификации. Листовые узлы могут относиться к любому из соответствующих классов K.
Машины опорных векторов
Машины опорных векторов
основаны на идее максимизации запаса, т.е. максимизации минимального расстояния от разделяющей гиперплоскости до ближайшего примера. Базовая SVM поддерживает только двоичную классификацию, но были предложены расширения для обработки и случая многоклассовой классификации. В этих расширениях к задаче оптимизации добавляются дополнительные параметры и ограничения для разделения различных классов.
Программирование мультивыражений
Программирование мультивыражений
(MEP) — это эволюционный алгоритм создания компьютерных программ (который также можно использовать для задач классификации). У MEP есть уникальная особенность: он кодирует несколько программ в одной хромосоме. Каждую из этих программ можно использовать для генерации выходных данных для класса, что делает MEP естественным образом подходящим для решения задач классификации нескольких классов.
Иерархическая классификация
решает проблему многоклассовой классификации путем разделения выходного пространства, т.е. на дерево
. Каждый родительский узел делится на несколько дочерних узлов, и процесс продолжается до тех пор, пока каждый дочерний узел не будет представлять только один класс. Было предложено несколько методов, основанных на иерархической классификации.
- В многомаркировочной классификации
, OvR известен как бинарная релевантность
и прогнозирование нескольких классов считается особенностью, а не проблемой.
- Мохамед, Али (2005). «Обзор по методам многоклассовой классификации»
. Технический отчет, Калифорнийский технологический институт
.
- ^ а
б
в
д
е
Бишоп, Кристофер М. (2006). Распознавание образов и машинное обучение
. Спрингер.
- Венкатесан, Раджасекар; Мэн Джу, Эр (2016). «Новая прогрессивная методика обучения для многоклассовой классификации». Нейрокомпьютеры
. 207
: 310–321. arXiv
: дои
: 10.1016/j.neucom.2016.05.006
. S2CID
12510650
.
- Венкатесан, Раджасекар. «Техника прогрессивного обучения»
.
Этот раздел пользователя выполняет указанный связанный с мультиобучением задач, в том числе мультиклассирует
, Мультилейбл
и мультивыход
классификации и регрессии.
Модули в этом разделе реализуют метаоценки
, для которых требуется, чтобы в их конструкторе была указана базовая стоимость. Мета-оценки расширяют возможности определения координат для поддержки задач с множественным обучением, что путем преобразования задач с множественным обучением в набор более простых задач, а затем подгонки одного оценщика для каждой задачи.
В этом разделе представлены два модуля: sklearn.multiclass
и sklearn.multioutput
. В приведенной ниже таблице показаны типичные проблемы, за которые отвечает каждый модуль, и соответствующие метаоценки, которые обеспечивают каждый модуль.
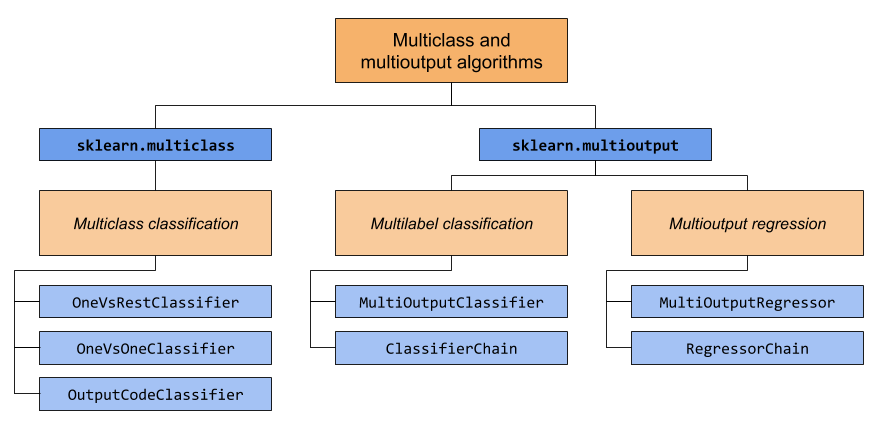
В таблице ниже приведены краткие сведения о различиях между типами проблем. Более подробные пояснения можно найти в следующих разделах данного руководства.
Ниже приводится сводка оценщиков scikit-learn, которые имеют встроенную поддержку множественного обучения, сгруппированных по стратегиям. Вам не нужны мета-оценщики, представленные в этом разделе, если вы используете одну из этих оценщиков. Однако метаоценки могут использовать дополнительные стратегии помимо встроенных:
